Visualizzazione post con etichetta grafici a scatola con i baffi. Mostra tutti i post

07 dicembre 2024

Grafici a scatola con i baffi (boxplot) con ggplot

I grafici a scatola con i baffi (o box plot o boxplot) sono una delle molte rappresentazioni grafiche dei dati che si possono realizzare con il pacchetto ggplot2. Come con gli altri post analoghi lo scopo è aiutare a rompere il ghiaccio con le funzioni di questo pacchetto, che possono risultare ostiche quando le si affronta per la prima volta.

Oltre al pacchetto ggplot2 [1] dovete accertarvi di avere installato – o dovete scaricare anche – il pacchetto DAAG [2] che contiene il set di dati ais impiegati nell'esempio, il pacchetto gridExtra che consente di combinare i grafici in una sola figura e il pacchetto forcats per l'ordinamento in base alla mediana dei gruppi.

Copiate e incollate nella Console di R questo script e premete ↵ Invio.

# BOXPLOT con ggplot
library(DAAG) # carica il pacchetto DAAG che include il set di dati ais
library(ggplot2) # carica il pacchetto per la grafica
library(gridExtra) # carica il pacchetto per combinare i grafici in una sola figura
#
# boxplot dell'emoglobina per sesso
plot1 <- ggplot(ais, aes(x=sex, y=hg)) + geom_boxplot(aes(fill=sex))
#
# riposiziona la legenda in basso
plot2 <- ggplot(ais, aes(x=sex, y=hg)) + geom_boxplot(aes(fill=sex)) + theme(legend.position="bottom") 
#
# aggiunge etichette degli assi e titolo
plot3 <- ggplot(ais, aes(x=sex, y=hg)) + geom_boxplot(aes(fill=sex)) + xlab("Sesso") + ylab("Emoglobina (g/dL)") + ggtitle("Boxplot per sesso")  
#
# centra il titolo e personalizza la legenda
plot4 <- ggplot(ais, aes(x=sex, y=hg)) + geom_boxplot(aes(fill=sex), notch=TRUE) + xlab("Sesso") + ylab("Emoglobina (g/dL)") + ggtitle("Boxplot per sesso") + theme(plot.title=element_text(hjust=0.5)) + labs(fill="Legenda") + scale_fill_hue(labels=c("f=donna", "m=uomo"))
#
# combina i grafici in una sola figura
grid.arrange(plot1, plot2, plot3, plot4, nrow=2, ncol=2) 
#

Dopo avere caricato i pacchetti necessari, sono generati quattro boxplot che sono salvati separatamente per essere al termine (solo per semplicità) combinati in una sola figura.

Per realizzare il primo grafico (plot1) viene impiegata innanzitutto la funzione ggplot()  che inizializza l'oggetto al quale sono collegate con il segno più [+] le successive funzioni, che sviluppano la grafica  che prevede:
→ come primo argomento il nome della tabella che contiene i dati (ais);
 come secondo argomento la funzione aes() che specifica di riportare in ascisse (x=) la variabile (fattore) sesso sex e in ordinate (y=) la variabile (numerica) hg che rappresenta la concentrazione di emoglobina espressa in grammi per decilitro di sangue (g/dL).

Alla funzione ggplot() viene quindi collegata con il segno più [+la funzione geom_boxplot() che realizza il grafico a scatola con i baffi specificando per il colore di riempimento (fill) dei boxplot una gamma di colori automatica con un colore differente per ciascun sesso (sex).

Da notare subito che questa è la struttura base che rimane identica in tutti e quattro i grafici realizzati, che si differenziano tra loro per le componenti grafiche via via aggiunte.

Il secondo grafico (plot2) quindi riprende tal quale la precedente struttura base e aggiunge semplicemente, tramite la funzione theme(), il posizionamento della legenda (legend.position) in basso sotto al grafico ("bottom").

Nel terzo grafico (plot3) viene eliminato il riposizionamento della legenda che viene pertanto lasciata nella posizione laterale prevista di default, quindi:
→ con la funzione xlab() viene aggiunta l'etichetta dell'asse delle ascisse;
→ con la funzione ylab() viene aggiunta l'etichetta dell'asse delle ordinate;
→ con la funzione ggtitle() viene riportato in alto un titolo per il grafico.

Il quarto grafico (plot4) riprende in toto le funzioni del terzo grafico e in aggiunta:
→ con notch=TRUE riporta sui box i limiti di confidenza al 95% della mediana;
→ con l'argomento plot.title della funzione theme() centra il titolo;
→ con labs() riporta l'intestazione della legenda;
→ con scale_fill_hue() riporta nella legenda le etichette che identificano i dati.

Infine con la funzione grid.arrange() i quattro grafici sono combinati in un'unica figura.


Copiate e incollate nella Console di R questo secondo script e premete ↵ Invio.

# BOXPLOT con ggplot
library(DAAG) # carica il pacchetto DAAG che include il set di dati ais
library(ggplot2) # carica il pacchetto per la grafica
library(gridExtra) # carica il pacchetto per combinare i grafici in una sola figura
library(forcats) # carica il pacchetto per l'ordinamento in base alla mediana
#
# boxplot dell'emoglobina per sport con dotplot
plot1 <- ggplot(ais, aes(x=sport, y=hg)) + geom_boxplot(aes(fill=sport)) +  ylim(10, 20) + theme(legend.position="none") + geom_dotplot(binaxis='y', stackdir='center', binwidth=0.3, color="black", fill="grey") 
#
# boxplot con incisura e ordinati in base alla mediana
plot2 <- ggplot(ais, aes(x=fct_reorder(sport, hg, median), y=hg)) + geom_boxplot(aes(fill=sport), notch=TRUE) +  ylim(10, 20) + theme(legend.position="none")
#
# boxplot per sesso con etichette in verticale e ampiezza dei boxplot ridotta
plot3 <- ggplot(ais, aes(x=fct_reorder(sport, hg, median), y=hg)) + geom_boxplot(aes(fill=sex), width=.75) +  ylim(10, 20) + theme(legend.position="none") + theme(axis.text.x=element_text(angle=90, hjust=1)) 
#
# unisce i grafici in una sola figura
grid.arrange(plot1, plot2, plot3, nrow=3, ncol=1) 
#

Il primo grafico (plot1) rispetto a quanto riportato nello script precedente prevede queste modifiche:
→ il fattore sesso viene sostituito con il fattore sport;
→ con la funzione ylim() viene personalizzata la scala delle ordinate;
→ con il valore "none" dell'argomento legend.position della funzione theme() viene eliminata la legenda;
→ con la funzione geom_dotplot() ai boxplot sono sovrapposti i grafici a punti (dotplot) centrati ('center') lungo l'asse delle ordinate ('y') con un diametro oppertunamente ridotto (0.3), tracciati in nero ("black") con riempimento in colore grigio ("grey").

Eliminata la parte più verbosa rappresentata dai grafici a punti (dotplot) sovrapposti, i grafici seguenti sono realizzati con piccole modifiche del codice.

Nel secondo grafico (plot2) viene eliminato il riposizionamento della legenda che viene pertanto lasciata nella posizione laterale prevista di default, quindi:
→ con la funzione fct_reoder() i box per sport sono riportati ordinati in base alla mediana (median) dell'emoglobina (hg);
→ con notch=TRUE viene riportata in ciascun box l'incisura che rappresenta i limiti di confidenza al 95% della mediana. Questo fornisce un test per la significatività della differenza tra le mediane: se le tacche o incisure di due boxplot non si sovrappongono, pur sovrapponendosi in parte le distribuzioni dei dati, le mediane delle due distribuzioni differiscono significativamente. Da notare che nella Console di R compare quattro volte un messaggio che avverte che le incisure sono uscite dai bordi della scatola negli sport Gym, Swim, T_Sprnt e W_Polo come risulta evidenziato nei rispettivi boxplot: la ragione è che in questi casi il numero delle osservazioni è ridotto e sconsiglia di trarre conclusioni statistiche. 

Nel terzo grafico (plot3) infine i boxplot sono ancora ordinati in base alla mediana dell'emoglobina per sport mentre:
→ in ciascuno sport sono ulteriormente suddivisi per sesso (fill=sex);
→ sono lievemente ristretti (width=.75);
→ con la funzione theme() le etichette sull'asse delle ascisse (axis.text.x) sono disposte in verticale.

Questa è la figura risultante.


Conclusione: i grafici a scatola con i baffi possono essere realizzati anche impiegando le sole funzioni contenute nella installazione base di R [3] con risultati sicuramente adeguati, tuttavia con il pacchetto ggplot2 è possibile realizzare ulteriori interessanti rappresentazioni.


---------- 

[1] Vedere la documentazione e il manuale di riferimento su:
https://cran.r-project.org/web/packages/ggplot2/index.html

[2] Vedere il post Il set di dati ais nel quale trovate anche come caricare i dati della tabella senza impiegare il pacchetto DAAG. 

12 luglio 2021

Analisi della varianza a due fattori

Il complesso di tecniche statistiche note come analisi della varianza (ANOVA) è stato introdotto con l'analisi della varianza a un fattore con la quale avevamo analizzato i dati di produzione di tre macchine, azionate da operatori non meglio specificati, con la domanda: le differenze tra le medie di produzione delle tre macchine possono essere attribuite al caso? Se così non fosse, dovremmo pensare che esiste qualcosa in grado di influenzare la produzione media delle macchine.

Il disegno sperimentale adottato aveva previsto di raccogliere i dati in modo tale che la variabilità osservata, misurata dalla differenza tra le medie di produzione delle i macchine, risultava essere quella determinata dal fattore macchina+operatore. Questi erano i dati riportati da Wonnacott [1] che abbiamo impiegato


e questo è il grafico che li rappresentava (in nero la media ± 2 deviazioni standard) e che mostra come medie risultassero tutte e tre significativamente diverse l'una dall'altra.


Ci proponiamo ora di fare un passo ulteriore: decomporre la variabilità osservata in variabilità dovuta al fattore macchina e variabilità dovuta al fattore operatore. Per questo impieghiamo di nuovo dati illustrati da Wonnacott [2], ma raccolti diversamente, che riportano nelle righe la produzione delle macchine e nelle colonne gli operatori che le azionano. Da notare che le medie [della produzione] delle macchine sono identiche alle precedenti, ma i dati hanno una distribuzione di valori più ampia, un fatto molto importante e che si ripercuote sulle conclusioni che dai dati possiamo trarre.


Il disegno sperimentale adottato ci consente di confrontare tra loro sia le medie delle i macchine (ultima colonna), sia le medie dei j diversi operatori (ultima riga) e analizzare le differenze tra le medie rispondendo separatamente a due domande:
→ le differenze tra le medie delle macchine possono essere attribuite al caso?
→ le differenze tra le medie degli operatori possono essere attribuite al caso? 

Se così non fosse (cioè se le differenze non possono essere attribuite al caso) dovremmo pensare che esiste qualcosa in grado di influenzare la produzione media delle macchine (ad esempio differenze strutturali, inadeguata manutenzione o altro) e/o qualcosa in grado di influenzare la produzione media degli operatori (ad esempio formazione dell'operatore, fenomeni di fatica o altro) [3].

I dati riportati in forma di tabella da Wonnacott per essere analizzati con R devono essere organizzati in un file di testo, sotto forma di righe (record) contenenti ciascuna tre variabili (campi), una prima variabile qualitativa (fattore) che indica la macchina, una seconda variabile qualitativa (fattoreche indica l'operatore e una variabile numerica che indica la produzione della combinazione macchina/operatore, e assumono quindi la forma seguente:

macchina;operatore;produzione
i1;j1;56.7
i1;j2;45.7
i1;j3;48.3
i1;j4;54.6
i1;j5;37.7
i2;j1;64.5
i2;j2;53.4
i2;j3;54.3
i2;j4;57.5
i2;j5;52.3
i3;j1;56.7
i3;j2;50.6
i3;j3;49.5
i3;j4;56.5
i3;j5;44.7

Copiate le sedici righe riportate qui sopra aggiungendo un ↵ Invio al termine dell'ultima riga e salvatele in C:\Rdati\ in un file di testo denominato anova2.csv (attenzione all'estensione .csv al momento del salvataggio del file).

In alternativa andate alla pagina Dati nella quale trovate diverse opzioni per scaricare i file di dati, quindi copiate il file anova2.csv nella cartella C:\Rdati\

Scaricate dal CRAN e installate il pacchetto ggplot2, con il quale realizzeremo una rappresentazione grafica dei dati integrativa all'analisi statistica.

Infine copiate e incollate nella Console di R questo script e premete ↵ Invio:

# ANOVA analisi della varianza a due fattori
#
mydata <- read.table("c:/Rdati/anova2.csv", header=TRUE, sep=";", dec=".") # importa i dati 
#
anova2 <- aov(produzione~macchina+operatore, data=mydata) # calcola la variabilità tra macchine e tra operatori
summary(anova2) # mostra i risultati
#
pairwise.t.test(mydata$produzione, mydata$macchina, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie delle macchine impiegando il test t con la correzione di bonferroni per confronti multipli
pairwise.t.test(mydata$produzione, mydata$operatore, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie degli operatori impiegando il test t con la correzione di bonferroni per confronti multipli 
#

Lo script è suddiviso in tre blocchi di codice. Nel primo blocco sono importati i dati con la funzione read.table().

Nel secondo viene eseguita l'analisi della varianza a un fattore mediante la funzione aov() (seconda riga) e sono riepilogati (terza riga) i risultati con la funzione summary():

            Df Sum Sq Mean Sq F value   Pr(>F)    
macchina     2  154.8   77.40   13.10 0.002997 ** 
operatore    4  381.7   95.43   16.15 0.000673 ***
Residuals    8   47.3    5.91                     
---
Signif. Codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

La varianza (Mean Sq) è calcolata dividendo la somma degli scarti quadratici (Sum Sq) per i gradi di libertà (Df). Il valore F (F value) viene calcolato separatamente per la macchina e per l'operatore, dividendo la varianza  dovuta alle macchine (77.40) per la varianza residua (5.91) ovvero dividendo la varianza  dovuta agli operatori (95.43) per la varianza residua (5.91) .

La probabilità (Pr(>F)) è la probabilità di osservare per caso il valore F e consente di rispondere alla domanda: le differenze tra le medie di produzione possono essere attribuite al caso? Per le medie di produzione delle macchine abbiamo un valore Pr(>F)= 0.002997  e per le medie di produzione degli operatori abbiamo un valore Pr(>F)= 0.000673. Poiché entrambi sono inferiori al valore 0.05 assunto in genere come valore soglia, concludiamo che le differenze osservate non sono attribuibili al caso o, se preferite, che sono significative: quindi esiste qualcosa in grado di influenzare la produzione a livello delle macchine e/o a livello degli operatori.

Il terzo blocco di codice consiste in due righe di codice, una per analizzare i dati delle macchine, e una analizzare i dati degli operatori. Abbiamo già visto che l'analisi della varianza a un fattore è una generalizzazione del test t di Student per dati non appaiati, ed è equivalente al test t quando i gruppi sono due [4]. Tuttavia esistono delle correzioni del test t che consentono di impiegarlo anche nel caso del confronto di più di due gruppi [5]. Queste correzioni controbilanciano l'aumento della probabilità, derivante dall'esecuzione di confronti multipli, di considerare la differenza tra le medie di due campioni come significativa quando invece non è significativa, ed è proprio una di queste, la correzione di Bonferroni (p.adjust.method = "bonferroni"), che viene qui applicata ai dati mediante la funzione pairwise.t.test(). Mentre l'ANOVA è un test globale, che ci dice che tra le medie esiste una qualche differenza, ma non ci consente di individuare la/e media/e responsabile/i di tale differenza, il test t viene effettuato per tutti i confronti possibili tra medie.

Il test t effettuato per tutti i confronti possibili tra macchine indica differenze sempre non significative - essendo sempre superiori a 0.05 le probabilità che le differenze tra medie qui osservate siano dovute al caso:

> pairwise.t.test(mydata$produzione, mydata$macchina, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie delle macchine impiegando la correzione di bonferroni per confronti multipli

        Pairwise comparisons using t tests with pooled SD 

data:  mydata$produzione and mydata$macchina 

   i1   i2  
i2 0.18 -   
i3 1.00 0.69

P value adjustment method: bonferroni 

Il test t effettuato per tutti i confronti possibili tra operatori ci indica che la significatività dall'ANOVA è dovuta ad un'unica differenza tra tutti i confronti effettuati: j1 risulta diverso da j5 con un valore p=0.029, di poco inferiore al valore soglia 0.05 comunemente adottato:

> pairwise.t.test(mydata$produzione, mydata$operatore, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie degli operatori impiegando la correzione di bonferroni per confronti multipli

        Pairwise comparisons using t tests with pooled SD 

data:  mydata$produzione and mydata$operatore 

   j1    j2    j3    j4   
j2 0.283 -     -     -    
j3 0.411 1.000 -     -    
j4 1.000 1.000 1.000 -    
j5 0.029 1.000 1.000 0.117

P value adjustment method: bonferroni 

Quindi mentre l'ANOVA indica la presenza nei dati di una qualche differenza significativa, il test t con la correzione di Bonferroni consente di rilevare dove questa si trova in quanto:
→ nel confronto tra le medie delle macchine indica differenze sempre non significative;
→ nel confronto tra le medie degli operatori indica che la differenza è imputabile ad un unico caso, quello degli operatori j1 e j5.

Se oltre alla libreria ggplot2 installate la libreria gridExtra potete realizzare un grafico a punti [6] che visualizza i dati della variabilità tra le macchine e un grafico a punti che visualizza i dati delle variabilità tra gli operatori, e combinarli in un'unica figura.

Copiate e incollate nella Console di R questo script e premete ↵ Invio:

#
library(ggplot2) # carica il pacchetto per la grafica
library(gridExtra) # carica il pacchetto per combinare i grafici
#
plot1 <- ggplot(mydata, aes(x=macchina, y=produzione, fill=macchina)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 70)) + labs(title="Variabilità tra le macchine", x="Macchina impiegata", y="Produzione realizzata") + theme_classic() # dotplot della produzione per macchina
#
plot2 <- ggplot(mydata, aes(x=operatore, y=produzione, fill=operatore)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 70)) + labs(title="Variabilità tra gli operatori", x="Operatore", y="Produzione realizzata") + theme_classic() # dotplot della produzione per operatore

grid.arrange(plot1, plot2, nrow = 1) # i due dotplot sono mostrati affiancati orizzontalmente
#


Se l'ANOVA consente di effettuare un confronto tra medie, a questo punto sembra logico sovrapporre ai dati raccolti la loro media e la loro deviazione standard.

Copiate e incollate nella Console di R queste quattro righe di codice che aprono una nuova finestra grafica nella quale viene rappresentato il grafico che sovrappone ai punti la media con l'intervallo corrispondente a due deviazioni standard:

#
windows() # apre e inizializza una nuova finestra grafica
#
plot1 <- ggplot(mydata, aes(x=macchina, y=produzione, fill=macchina)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 70)) + labs(title="Variabilità tra le macchine", x="Macchina impiegata", y="Produzione realizzata") + theme_classic() + stat_summary(fun.data = mean_sdl, fun.args=list(mult=2), geom="pointrange", color="black", show.legend = FALSE) # dotplot della produzione per macchina +/- 2 deviazioni standard
#
plot2 <- ggplot(mydata, aes(x=operatore, y=produzione, fill=operatore)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 70)) + labs(title="Variabilità tra gli operatori", x="Operatore", y="Produzione realizzata") + theme_classic() + stat_summary(fun.data = mean_sdl, fun.args = list(mult=2), geom="pointrange", color="black", show.legend=FALSE) # dotplot della produzione per macchina +/- 2 deviazioni standard
#
grid.arrange(plot1, plot2, nrow = 1) # i due dotplot sono mostrati affiancati orizzontalmente
#

Da notare che nella funzione stat_summary() l'argomento mult=2 che specifica di rappresentare attorno alla media l'intervallo uguale a 2 deviazioni standard può essere modificato.

La rappresentazione grafica dei dati ci viene nuovamente in aiuto nell'interpretazione dei risultati. Come si vede in questo caso i dati sono molto dispersi, e gli intervalli media ± 2 deviazioni standard sono ampiamente sovrapposti: e questo corrobora la non significatività delle differenze tra le medie. Da notare la notevole differenza rispetto ai dati dell'ANOVA a un fattore riportati nella prima figura in alto. La maggior differenza rilevata graficamente è quella tra operatore j1 e operatore j5 ed è in linea con la debole (appena inferiore a 0.05) significatività statistica (p=0.029) di tale differenza. 


La conclusione? Impiegando i dati tratti da un testo di statistica abbiamo sviluppato due esempi di analisi della varianza, a un fattore e a due fattori, dai quali possiamo ricavare alcune considerazioni interessanti:
→ l'analisi della varianza (ANOVA), a dispetto del nome, è un insieme di tecniche per effettuare confronti multipli tra medie;
→ perché l'ANOVA fornisca risultati affidabili è necessario verificare in via preliminare che i dati siano distribuiti in modo gaussiano e con varianze omogenee, eseguendo i test opportuni;
→ l'ANOVA fornisce come risultato un rapporto tra varianze (il test F), che è un test globale che ci dice che tra le medie esiste una qualche differenza, ma non specifica la/e media/e responsabile/i di tale differenza;
→ nel caso limite in cui il confronto tra medie è limitato a due campioni l'ANOVA equivale al test t di Student per dati non appaiati (campioni indipendenti);
→ i confronti multipli tra medie possono essere effettuati anche impiegando test alternativi come il test t con opportune correzioni, ad esempio con la correzione di Bonferroni, con il vantaggio, in questo caso, che la significatività viene valutata separatamente per ciascuna coppia di medie poste a confronto;
→ il valore soglia p=0.05 non è un dogma, e qualora si ritenga opportuno essere più prudenti (conservativi) nel giudicare la significatività di un test statistico si può adottare un valore soglia inferiore come per esempio p=0.01;
→ quando i dati sono poco dispersi e l'intervallo media ± 2 deviazioni standard non si sovrappone i risultati di ANOVA e test t (con le opportune correzioni) sono uguali in quanto l'informazione fornita dai dati è elevata, lascia poco adito a dubbi [sulla significatività delle differenze tra le medie] e la diversità degli assunti alla base delle tecniche statistiche impiegate non porta a conclusioni diverse;
→ quando i dati sono molto dispersi e l'intervallo media ± 2 deviazioni standard è ampiamente sovrapposto (vedere la seconda e la terza immagine riportate qui sopra), i risultati di ANOVA e test t (con le opportune correzioni) possono differire in quanto l'informazione fornita dai dati è scarsa, lascia adito a molti dubbi [sulla significatività delle differenze tra le medie] e la diversità degli assunti alla base delle tecniche statistiche impiegate può portare a conclusioni diverse;
→ la rappresentazione grafica dei dati rappresenta come sempre una importante integrazione ai test statistici.

In sintesi anche i risultati dell'ANOVA, come del resto tutti i risultati dell'analisi statistica, non devono essere interpretati in modo schematico e rigido, ma devono essere interpretati:
→ verificando che i dati analizzati rispettino gli assunti di normalità e omogeneità delle varianze previsti dall'ANOVA;
→ integrando i risultati dell'ANOVA con quelli di test alternativi per il confronto tra medie;
→ valutando criticamente le eventuali discrepanze tra i risultati dell'ANOVA e dei test alternativi;
→ adottando al bisogno requisiti di significatività più stringenti del tradizionale p=0.05;
→ integrando i risultati dell'ANOVA e dei test alternativi con l'esplorazione grafica dei dati;
→ traendo le conclusioni sulla base di una valutazione globale dei risultati ottenuti.

Il che ci ricorda che tutto sommato in statistica il rigore scientifico dei modelli matematici e dei numeri dovrebbe sempre essere integrato con il buonsenso, al quale può contribuire in modo importante una adeguata rappresentazione grafica.


----------

[1] Wonnacott TH, Wonnacott RJ. Introduzione alla statistica. Franco Angeli Editore, Milano, 1980, ISBN 88-204-0323-4, Tabella 10-1, p. 238.

[2] Wonnacott TH, Wonnacott RJ. Introduzione alla statistica. Franco Angeli Editore, Milano, 1980, ISBN 88-204-0323-4, Tabella 10-9, p. 255.

[3] Si ricorda che l'analisi della varianza è basata su due assunti: (i) che i dati siano distribuiti in modo gaussiano e (ii) che la varianza sia la stessa nei diversi gruppi confrontati. Per i test da impiegare per verificare che questi due assunti siano rispettati vedere il post Analisi della varianza a un fattore.


[6] Per i dettagli delle funzioni e degli argomenti impiegati per questa rappresentazione grafica si rimanda al post Grafici a punti (dotplot) mentre nel post Grafici a violino (violin plot) trovate anche come sovrapporre ai punti un grafico a violino o un grafico a scatola con i baffi (boxplot).

22 maggio 2021

Analisi della varianza a un fattore

Anche se può sembrare paradossale, l'analisi della varianza consente di effettuare il confronto tra medie. Infatti come è stato sottolineato, a dispetto della “... apparente incoerenza della nomenclatura – il fatto cioè che le tecniche riguardino confronti di medie piuttosto che varianze – ... il complesso delle tecniche chiamato analisi della varianza costituisce un potente metodo per analizzare il modo in cui il valore medio di una variabile è influenzato da classificazioni di vario genere dei dati” [1].

Ancor più direttamente Wonnacott all'inizio del capitolo dedicato all'analisi della varianza riporta: "... abbiamo compiuto inferenze relative alla media di una popolazione ... abbiamo esteso il ragionamento alla differenza fra due medie ... vogliamo confrontare ora r medie, usando un insieme di tecniche che vengono comunemente denominate «analisi della varianza»" [2].  

Le tecniche di analisi della varianza (ANOVA) sono ampiamente trattate in tutti i testi di statistica, ai quali si rimanda per i necessari approfondimenti. Vediamo in questo post la più semplice di queste tecniche, l'analisi della varianza a un fattore che:
→ è "... una generalizzazione del test t [di Student] per [il confronto tra medie di] dati non appaiati [due campioni indipendenti], adatta a un numero qualunque di gruppi ..." [1];
→ è "... equivalente al test t per [il confronto tra medie nel caso di] dati non appaiati quando i gruppi sono ... due" [1];
→ è basata "... su due importanti ipotesi: (a) la normalità delle distribuzioni delle osservazioni ... e (b) la costanza delle varianze nei diversi gruppi" [3].

Per la verifica preliminare di queste due ultime ipotesi – normalità delle distribuzioni e omogeneità (costanza) delle varianze – si rimanda ai post riportati in [4].

I problemi che si presentano nella pratica quando gli assunti alla base del modello statistico dell'ANOVA non sono completamente soddisfatti – e i correttivi che possono eventualmente essere adottati – vanno al di la dei limiti di questo blog, ma sono ben approfonditi per esempio da Snedecor [5].

Per lo script impieghiamo i dati riportati da Wonnacott che riguardano "... tre macchine (A, B e C), le quali, essendo azionate da uomini e a causa di altre ragioni inesplicabili, danno luogo ad un prodotto orario soggetto a fluttuazioni casuali. Nella speranza di «mediare» e quindi di ridurre gli effetti di tali fluttuazioni, si effettua un campione casuale di 5 ore per ciascuna macchina, i cui risultati sono raccolti nella Tabella 10-1 insieme con le relative medie" [6].


La domanda è: le differenze tra le medie di produzione 48.6, 56.4 e 51.6, riportate nell'ultima colonna sulla destra, possono essere attribuite al caso? Se così non fosse, dovremmo pensare che esiste qualcosa in grado di influenzare la produzione media delle macchine.

I dati riportati in forma di tabella da Wonnacott per essere analizzati con R devono essere organizzati in un file di testo, sotto forma di righe (record) contenenti ciascuna due variabili (campi), una variabile qualitativa (fattore) che indica la macchina, e una variabile numerica che indica la produzione della macchina, e assumono quindi la forma seguente:


macchina;produzione
i1;48.4
i1;49.7
i1;48.7
i1;48.5
i1;47.7
i2;56.1
i2;56.3
i2;56.9
i2;57.6
i2;55.1
i3;52.1
i3;51.1
i3;51.6
i3;52.1
i3;51.1

Copiate le sedici righe riportate qui sopra aggiungendo un ↵ Invio al termine dell'ultima riga e salvatele in C:\Rdati\ in un file di testo denominato anova1.csv (attenzione all'estensione .csv al momento del salvataggio del file).

In alternativa andate alla pagina Dati nella quale trovate diverse opzioni per scaricare i file di dati, quindi copiate il file anova1.csv nella cartella C:\Rdati\


Poi scaricate dal CRAN e installate il pacchetto ggplot2, con il quale realizzeremo una rappresentazione grafica dei dati integrativa all'analisi statistica.

Infine copiate e incollate nella Console di R questo script e premete ↵ Invio:

 
# ANOVA analisi della varianza a un fattore
#
mydata <- read.table("c:/Rdati/anova1.csv", header=TRUE, sep=";", dec=".") # importa i dati
#
anova1 <- aov(produzione~macchina, data=mydata) # esegue l'analisi della varianza
summary(anova1) # mostra i risultati dell'analisi della varianza
#
pairwise.t.test(mydata$produzione, mydata$macchina, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie delle macchine impiegando il test t con la correzione di Bonferroni per confronti multipli
#

Lo script è suddiviso in tre blocchi di codice. Nel primo sono importati i dati con la funzione read.table().

Nel secondo viene eseguita l'analisi della varianza a un fattore mediante la funzione aov() (seconda riga) e sono riepilogati (terza riga) i risultati con la funzione summary():


> summary(anova1) # mostra i risultati dell'analisi della varianza
            Df Sum Sq Mean Sq F value   Pr(>F)    
macchina     2 154.80   77.40   141.6 4.51e-09 ***
Residuals   12   6.56    0.55                     
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

La varianza (Mean Sq) è calcolata dividendo la somma degli scarti quadratici (Sum Sq) per i gradi di libertà (Df). Il valore F (141.6) del rapporto fra varianze (F value) viene calcolato dividendo la varianza dovuta alle macchine (77.40) per la varianza residua (0.55).

La probabilità (Pr(>F)) è la probabilità di osservare per caso il valore F (141.6) e consente di rispondere alla domanda: le differenze tra le medie di produzione possono essere attribuite al caso? Essendo tale probabilità 4.51e-09 o se preferite 0.0000000451, quindi molto inferiore al valore 0.05 assunto in genere come valore soglia, concludiamo che le differenze tra le medie di produzione non sono attribuibili al caso: le medie sono significativamente diverse, quindi esiste qualcosa in grado di influenzare la produzione [media] delle macchine

Da notare una cosa molto importante: l'ANOVA è un test globale e ci dice che tra le medie [nel nostro caso tra le medie di produzione delle tre macchine] esiste una differenza significativa, ma non consente di individuare la/e media/e causa della significatività. In altre parole non ci dice se la significatività sia dovuta alla differenza tra la prima macchina e la seconda, tra la prima macchina e la terza, tra la seconda macchina e la terza, o a una qualche combinazione di queste tre possibilità. Se è questo che interessa, è possibile ricorrere a test alternativi (vedi sotto).

Il terzo blocco di codice consiste anch'esso in una sola riga. Abbiamo già visto che l'analisi della varianza a un fattore è una generalizzazione del test t di Student per dati non appaiati, ed è equivalente al test t quando i gruppi sono due [7]. Tuttavia esistono delle correzioni del test t che consentono di impiegarlo anche nel caso del confronto di più di due gruppi [8], ed è proprio una di queste, la correzione di Bonferroni (p.adjust.method = "bonferroni"), che viene qui applicata ai dati mediante la funzione pairwise.t.test() per confrontarne i risultati con quelli dell'ANOVA

pairwise.t.test(mydata$produzione, mydata$macchina, p.adjust.method = "bonferroni") # confronto tra le (produzioni) medie delle macchine impiegando la correzione di Bonferroni per confronti multipli

        Pairwise comparisons using t tests with pooled SD 

data:  mydata$produzione and mydata$macchina 

   i1      i2     
i2 3.4e-09 -      
i3 1.0e-04 8.1e-07

P value adjustment method: bonferroni 

Come si vede il test t effettuato per tutti e tre i confronti possibili tra macchine conferma i risultati dell'ANOVA riportando differenze sempre significative – essendo sempre inferiori a 0.05 le probabilità che le differenze tra medie qui osservate siano dovute al caso – ma ci indica anche dove risiedono tali differenze, riportando separatamente che i1 <> i2 (p=3.4e-09), i1 <> i3 (p=1.0e-04), i2 <> i3 (p=8.1e-07), cosa che l'ANOVA, essendo un test globale, non consente di specificare (vedi sopra). 

Altre correzioni alternative, meno conservative della correzione di Bonferroni [9], possono essere impiegate con l'argomento p.adjust.method = : secondo Holm (1979) ("holm"), Hochberg (1988) ("hochberg"), Hommel (1988) ("hommel"), Benjamini & Hochberg (1995) ("BH" o "fdr"), Benjamini & Yekutieli (2001) ("BY"), e "none" per nessuna correzione.

Se installate  la libreria ggplot2 potete realizzare un grafico a punti (dotplot) [10] che consente di visualizzare i dati: il che è sempre un importante complemento all'analisi numerica. Copiate e incollate nella Console di R questo script e premete ↵ Invio:
 
#
library(ggplot2) # carica il pacchetto per la grafica
#
ggplot(mydata, aes(x=macchina, y=produzione, fill=macchina)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 60)) + labs(title="Variabilità osservata nella produzione tra le macchine", x="Macchina impiegata", y="Produzione realizzata") + theme_classic() # dotplot della produzione per macchina
#


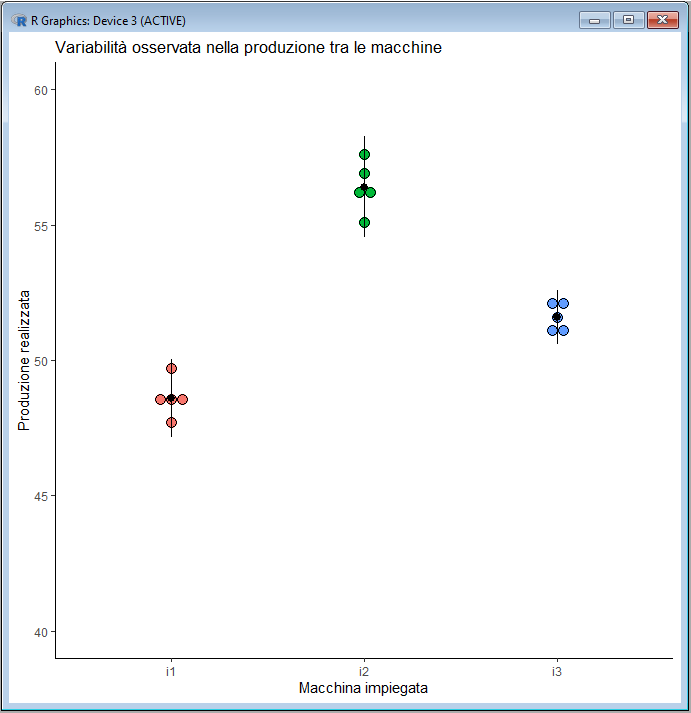
Se l'ANOVA consente di effettuare un confronto tra medie, a questo punto sembra logico sovrapporre ai dati raccolti la loro media e la loro deviazione standard.

Copiate e incollate nella Console di R queste due righe di codice che aprono una nuova finestra grafica nella quale viene rappresentato il grafico precedente sovrapponendo poi ai punti la media con l'intervallo corrispondente a due deviazioni standard:

#
windows() # apre e inizializza una nuova finestra grafica
#
ggplot(mydata, aes(x=macchina, y=produzione, fill=macchina)) + geom_dotplot(binaxis='y', stackdir='center', stackratio=1, dotsize=1, binwidth=0.4, show.legend=FALSE) + coord_cartesian(ylim=c(40, 60)) + labs(title="Variabilità osservata nella produzione tra le macchine", x="Macchina impiegata", y="Produzione realizzata") + theme_classic() + stat_summary(fun.data=mean_sdl, fun.args = list(mult=2), geom="pointrange", color="black", show.legend=FALSE) # aggiunge media +/- 2 deviazioni standard
#


Da notare che nella funzione stat_summary l'argomento mult=2 che specifica di rappresentare attorno alla media l'intervallo uguale a 2 deviazioni standard può essere modificato. 

La rappresentazione grafica dei dati ci viene nuovamente in aiuto nell'interpretazione dei risultati: come si vede i dati sono poco dispersi, le medie sono ben differenti, gli intervalli media ± 2 deviazioni standard non si sovrappongono, e questo conferma la significatività delle differenze tra le medie.

Dal punto di vista statistico è interessante notare l'importanza del disegno sperimentale. Quello qui adottato prevedeva di raccogliere i dati in modo tale che la variabilità osservata è quella dovuta al fattore macchina+operatore, pertanto non è possibile stabilire se le differenze (tra medie) osservate sono imputabili alla sola macchina, al solo operatore o a entrambi.

Impiegando un altro disegno sperimentale, e raccogliendo i dati diversamente, è possibile decomporre la variabilità osservata in variabilità dovuta al fattore macchina e variabilità dovuta al fattore operatore. lo facciamo nel post Analisi della varianza a due fattori, al termine del quale trovate anche alcune considerazioni generali sull'ANOVA.


----------


[1] Armitage P. Statistica medica. Giangiacomo Feltrinelli Editore, Milano, 1979, p. 188.

[2] Wonnacott TH, Wonnacott RJ. Introduzione alla statistica. Franco Angeli Editore, Milano, 1980, ISBN 88-204-0323-4, p. 237.

[3] Armitage P. Statistica medica. Giangiacomo Feltrinelli Editore, Milano, 1979, pp. 195-196.

[4] Vedere il post Valutare l'omogeneità tra varianze e, per l'analisi della normalità (gaussianità) dei dati, i post:

[5] Snedecor GW, Cochran WG. Statistical Methods. The Iowa State University Press, 1980, ISBN 0-8138-1560-6. Chapter 15 - Failures in the assumptions, pp. 274-297.

[6] Wonnacott TH, Wonnacott RJ. Introduzione alla statistica. Franco Angeli Editore, Milano, 1980, ISBN 88-204-0323-4, Tabella 10-1, p. 238.


[8] Vedere il post Test parametrici e non parametrici per più campioni indipendenti per il significato di queste correzioni, che controbilanciano l'aumento della probabilità, derivante dall'esecuzione di confronti multipli, di considerare la differenza tra le medie di due campioni come significativa quando invece non è significativa.

[9] Un test statistico più conservativo a parità di condizioni produce come risultato un valore di p più alto quindi ci aspettiamo che a lungo andare fornisca un numero inferiore di differenze significative, mentre un test statistico meno conservativo a parità di condizioni produce come risultato un valore di p più basso quindi ci aspettiamo che a lungo andare fornisca un numero maggiore di differenze significative.

[10] Si rimanda al post Grafici a punti (dotplot), inoltre nel post Grafici a violino (violin plot) trovate anche come sovrapporre ai punti un grafico a violino o un grafico a scatola con i baffi (boxplot).